Door Sven Bennema, AI Engineer bij DIKW
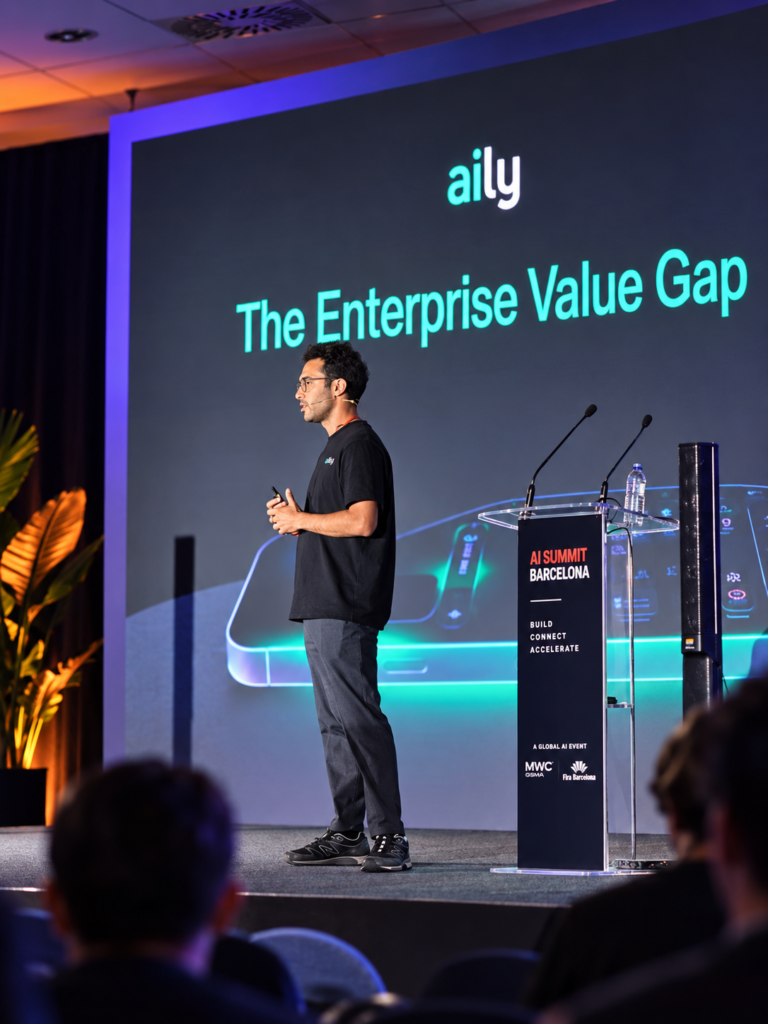
Tijdens AI Summit Barcelona 2026 stond niet vooral het nieuwste model centraal, maar een moeilijkere en relevantere vraag: hoe maken organisaties van AI betrouwbare systemen die daadwerkelijk kunnen meedraaien in processen, besluitvorming en softwareontwikkeling? Hoe maak je betrouwbare AI-agents?
In keynotes, workshops, demo’s en gesprekken kwamen steeds dezelfde bouwstenen terug: context, memory, data, governance, evaluatie, security en menselijke controle. Het model blijft belangrijk, maar vormt steeds vaker slechts één component van een groter systeem.
De slogan van het event was “Beyond Theory. AI in Action.” Die paste goed bij de rode draad van de week: AI verschuift van experiment en demo naar engineering, beheer en organisatiebreed gebruik.
"De toekomst van enterprise AI wordt niet bepaald door wie het beste model gebruikt, maar door wie het beste systeem eromheen bouwt."
Sven Bennema
De week begon vóór de Summit
Mijn AI-week in Barcelona begon op maandag tijdens een Claude Community-dag. Engineers, architecten en organisaties deelden daar praktijkervaringen met Claude, coding agents, second brains, observability en agentic workflows.
Die dag liet vooral zien hoe AI-tools nu al onderdeel worden van softwareontwikkeling en kenniswerk. Tijdens de Summit werd diezelfde ontwikkeling breder getrokken naar enterprise-architectuur, dataplatformen, security, pricing en organisatieverandering.
De combinatie was interessant: eerst zien hoe builders de technologie vandaag gebruiken, daarna onderzoeken wat nodig is om die technologie op grotere schaal betrouwbaar toe te passen.

Van snelle adoptie naar volwassen AI
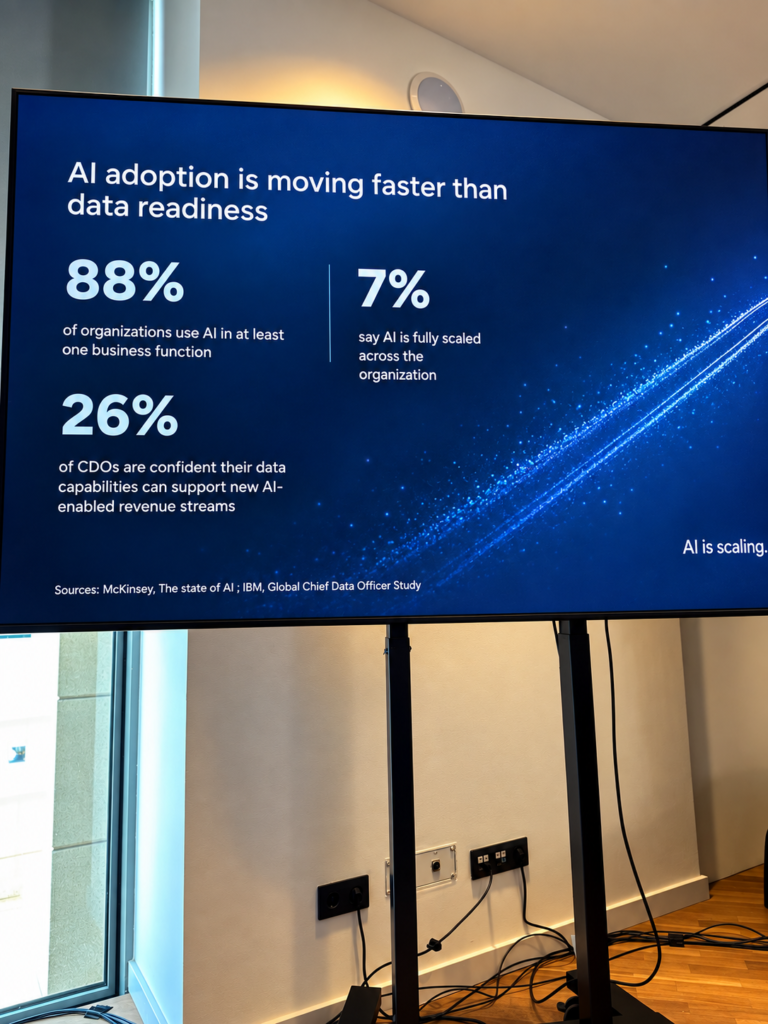
Veel organisaties gebruiken AI inmiddels ergens in hun werk. Toch lukt het nog relatief weinig organisaties om AI breed, veilig en herhaalbaar toe te passen.
Dat verschil zit zelden alleen in de keuze voor een model. Het gaat om data readiness, integratie met bestaande systemen, security, governance en duidelijk ownership. De volgende bottleneck is dus steeds minder het model zelf en steeds vaker de omgeving waarin het model moet functioneren.
Voor organisaties betekent dit dat een AI-roadmap verder moet gaan dan een lijst met interessante use cases. De vragen beginnen bij de basis: welke data is betrouwbaar en beschikbaar, wie is eigenaar van een AI-proces, welke beslissingen mag een systeem ondersteunen of uitvoeren, en welke controles blijven nodig?
Dat raakt direct aan datastrategie, datamanagement en AI-governance. Wie AI duurzaam wil opschalen, heeft een fundament nodig waarop losse experimenten gecontroleerd kunnen doorgroeien naar productie.
[Lees meer over AI adoptie als een oneindige lus]
De menselijke kant van AI
Naast technische onderwerpen was er veel aandacht voor de menselijke kant van AI. Wat gebeurt er met professioneel oordeel, kritisch denken en leren wanneer systemen steeds meer cognitief werk kunnen overnemen?
AI kan mensen productiever maken, maar organisaties moeten voorkomen dat kennis, vakmanschap en verantwoordelijkheid ongemerkt verdwijnen. De relevante vraag is dus niet alleen hoe medewerkers sneller kunnen werken met AI, maar ook hoe zij capabel en verantwoordelijk blijven terwijl systemen autonomer worden.
Human-in-the-loop is daarom geen algemene knop die je aan of uit zet. Het vraagt om bewuste keuzes: welke taken mag een agent zelfstandig uitvoeren, welke acties vereisen menselijke goedkeuring en wie blijft verantwoordelijk voor de uitkomst?
Succesvolle AI-adoptie vraagt dus niet alleen om technologie. Teams hebben ook nieuwe werkafspraken, duidelijke verantwoordelijkheden en voldoende AI-geletterdheid nodig om output te beoordelen, te corrigeren en verantwoord te gebruiken.
[Lees meer over de opleiding : Leiderschap in AI bij DIKW Academy]


Wanneer code goedkoper wordt
Een duidelijk technisch thema was de veranderende economie van softwareontwikkeling. Als coding agents steeds grotere hoeveelheden code kunnen genereren, wordt het schrijven van code zelf minder vaak de belangrijkste bottleneck.
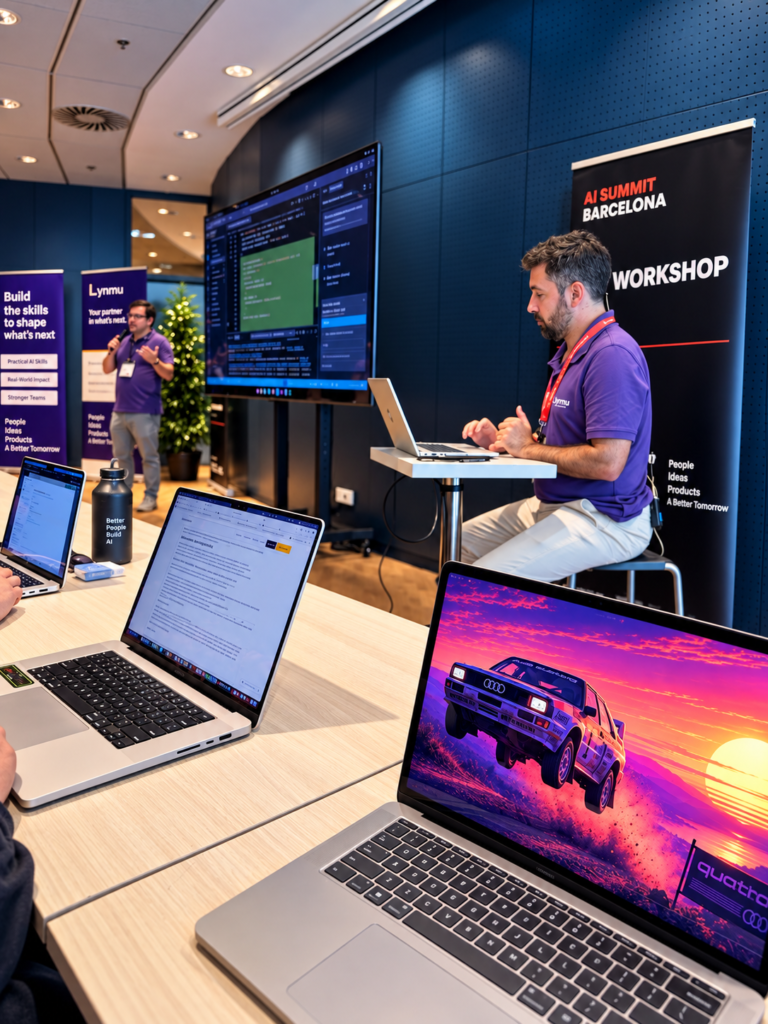
Review, validatie, traceerbaarheid en governance worden juist belangrijker.
Coding agents hebben daarom niet alleen toegang nodig tot repositories, maar ook tot specificaties, richtlijnen, tests en de grenzen waarbinnen zij mogen opereren. De workflow verschuift van:
Prompt → Model → Code
Naar:
Specificatie → Agent → Tools → Validatie → Evaluatie → Human gate → Deployment
In de praktijk betekent dit dat AI-ondersteund ontwikkelen een volwassen delivery system vraagt. Geef agents toegang tot de informatie die zij nodig hebben, maar begrens die toegang. Maak tests, codekwaliteit, security checks en dependency-scans onderdeel van de workflow. Leg bovendien vast wanneer een wijziging altijd menselijke review of expliciete goedkeuring vereist.
De kernvraag is niet: kunnen we code laten genereren? De kernvraag is: kunnen we sneller software opleveren zonder grip op kwaliteit, security en onderhoudbaarheid te verliezen?
Van vibe checks naar evaluation loops
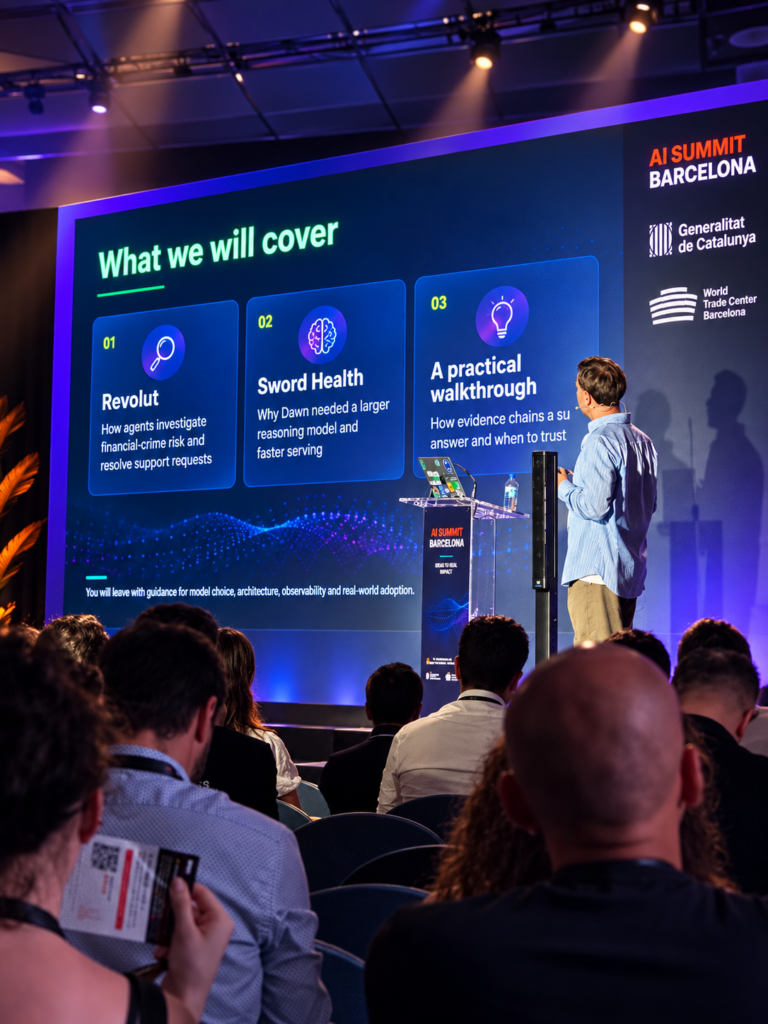
Dat een AI-demo één keer werkt, is nog geen bewijs dat een systeem klaar is voor productie.
Zodra een agent echt werk uitvoert, moet je kunnen bepalen of een nieuw model, aangepaste prompt, extra context of nieuwe tool het systeem werkelijk verbetert. En ook of die verandering niet op een ander vlak tot regressie leidt.
Daarom komt AI-engineering steeds dichter bij software-engineering: met testsets, regressiesuites, observability en reproduceerbare evaluaties. Het verschil is dat AI-output vaak probabilistisch is. Je beoordeelt dus niet alleen of een functie exact het verwachte resultaat teruggeeft, maar ook of een agent de juiste bronnen gebruikt, binnen zijn bevoegdheden blijft en een taak betrouwbaar uitvoert.
Voor iedere use case moet vooraf duidelijk zijn wat kwaliteit betekent: juistheid, volledigheid, brongebruik, veiligheid, doorlooptijd, kosten en het aantal gevallen waarin menselijke interventie nodig is. Wijzigingen in modellen, prompts, RAG, tools of workflows test je vervolgens eerst tegen representatieve scenario’s, voordat zij productie bereiken.
[Lees meer over Loop Engineering of de training AI-native software ontwikkeling]
Context, memory en state als architectuur
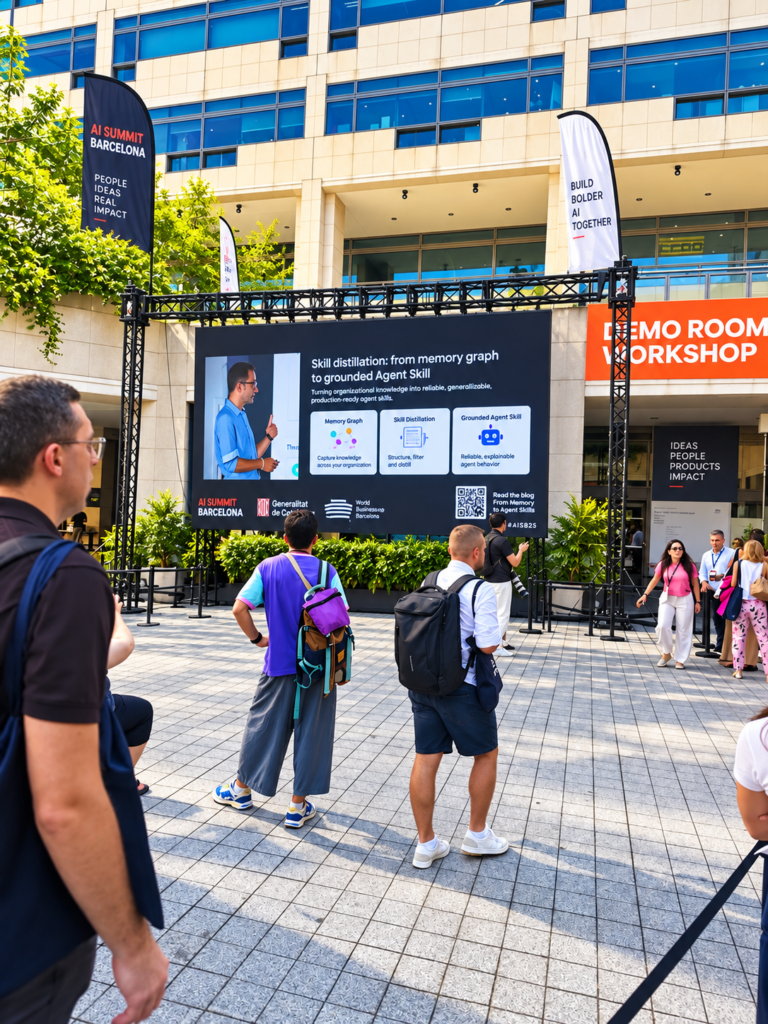
Context en memory waren een ander terugkerend onderwerp. Een sterk model zonder persistente state begint iedere interactie grotendeels opnieuw. Maar alles opslaan is minstens zo riskant: het leidt tot irrelevante context, verouderde kennis, privacyrisico’s en een onduidelijke herkomst van informatie.
De ontwerpvraag is dus niet alleen wat een agent moet onthouden, maar ook wat hij moet vergeten.
In de loop van de tijd kunnen losse interacties veranderen in gestructureerde kennis, workflows en herbruikbare skills. Dat maakt agents krachtiger, maar stelt ook eisen aan bronvermelding, actualiteit, privacy en beheer.
In de praktijk vraagt dit om onderscheid tussen tijdelijke sessiecontext, persoonlijke instellingen, gevalideerde bedrijfskennis en informatie die nodig is voor audit of opvolging. Leg vast waar kennis vandaan komt, wie eigenaar is, hoe correcties worden verwerkt en hoe lang gegevens bewaard mogen blijven. Daarmee voorkom je dat een agent handelt op basis van oude, onjuiste of ongeautoriseerde informatie.
De datalaag onder ieder AI-systeem
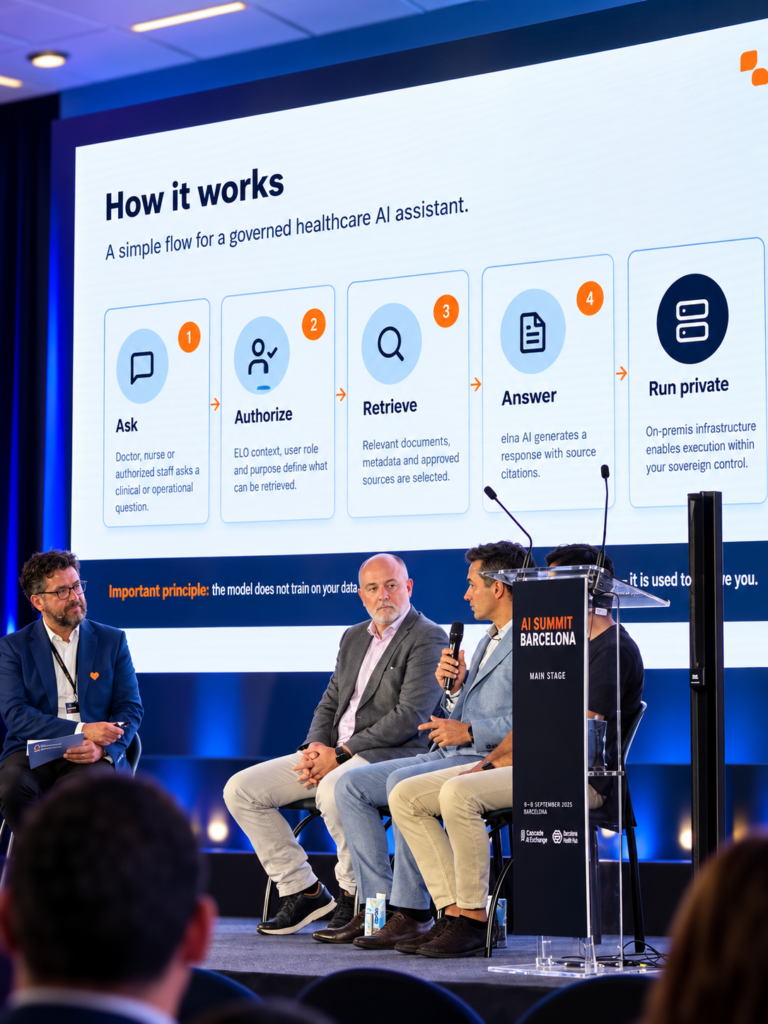
Een van de eenvoudigste, maar sterkste diagrammen van het event was:
Ask → Authorize → Retrieve → Answer → Run private
Het maakt zichtbaar dat een model slechts één onderdeel is van een AI-systeem. Identity bepaalt waartoe iemand toegang heeft. Context bepaalt welke informatie relevant is. Retrieval levert de onderbouwing. Governance bepaalt wat het systeem mag doen. En infrastructuur bepaalt waar data en inference mogen draaien.
Dezelfde gedachte kwam terug in sessies over AI-powered analytics. Analytics verschuift van systemen die informatie tonen naar systemen die op basis van governed data kunnen redeneren en acties kunnen initiëren.
Een AI-agent die vragen beantwoordt over omzet, klanten, voorraad, risico’s of projecten moet daarom meer weten dan waar de data staat. Hij moet ook begrijpen welke bron leidend is, welke definitie hoort bij een KPI, hoe actueel gegevens zijn, welke gebruiker toegang heeft en welke acties toegestaan zijn.
Daarom worden semantic layers, metadata, lineage, business rules en identity niet minder belangrijk in een AI-tijdperk. Zij vormen juist de betrouwbare context waarop een agent moet kunnen redeneren.
Dit raakt aan de manier waarop wij bij DIKW naar AI-native dataplatformen kijken. Betrouwbare AI ontstaat niet door een model los op organisatiedata te zetten. Data, metadata, definities, autorisaties en domeinkennis vormen samen het fundament waarop een agent veilig en bruikbaar kan werken.
Agents bouwen is systems engineering
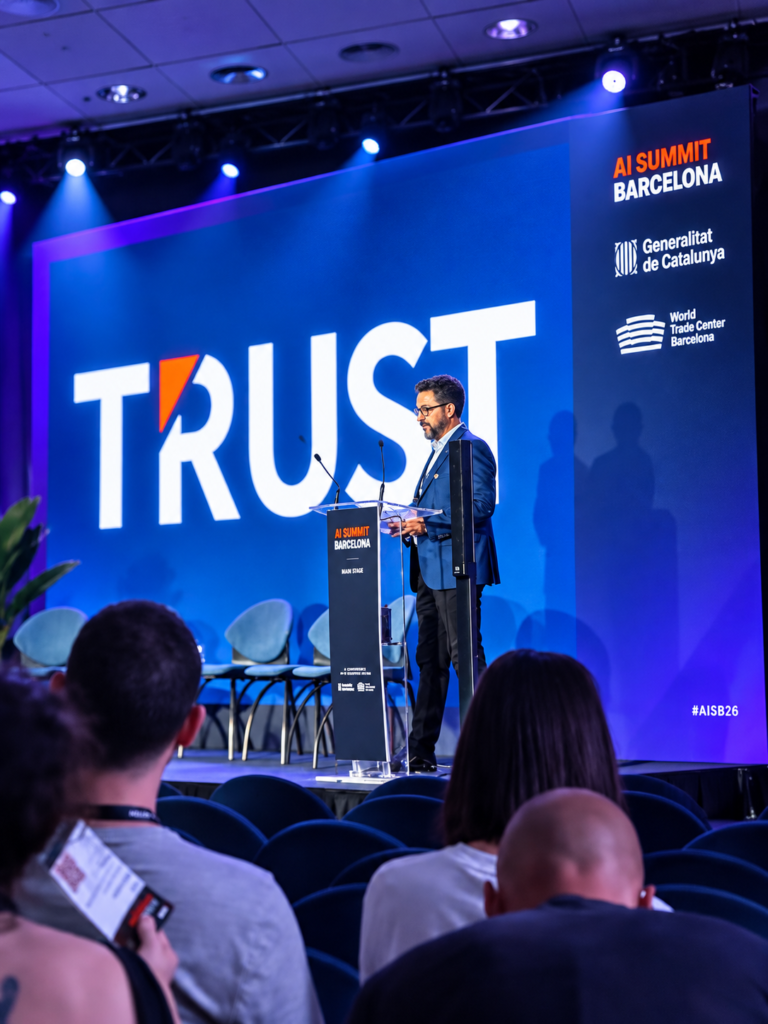
Het woord trust kwam tijdens de Summit vaak terug. Niet als abstracte belofte, maar als architectuurvraagstuk.
Betrouwbare agents hebben begrijpelijke context, beperkte permissies, observeerbare acties, evaluaties, controles en duidelijke menselijke beslismomenten nodig. Modelselectie, orchestration, datapipelines, infrastructuur en governance zijn geen losse componenten. Ze vormen samen één systeem.
Een agent een taak laten uitvoeren wordt steeds eenvoudiger. Een agent diezelfde taak betrouwbaar, herhaalbaar en veilig laten uitvoeren binnen een echte organisatie: daar begint het echte engineeringwerk.
De beste startvraag is daarom niet welk model of welke agenttool je moet kiezen. Begin bij de taak, het proces en de risico’s. Welk probleem moet worden opgelost? Welke data en systemen zijn nodig? Welke rechten zijn noodzakelijk, welke juist niet? Welke fouten zijn acceptabel? Hoe meet je resultaat? En wanneer moet een mens beslissen?
[Lees verder in het blog Humans first agents second]

Van tooling naar delivery systems
AI-tools worden steeds minder als losse hulpmiddelen gezien en steeds vaker als onderdeel van complete delivery systems. Dat gold voor coding agents, maar ook voor analytische agents, customer-facing agents en interne procesautomatisering.
De relevante vraag verschuift daarmee van:
Welke AI-tool moeten we gebruiken?
Naar:
Hoe ontwerpen we een omgeving waarin agents, tools, data en mensen betrouwbaar samenwerken?
Een sterke AI-oplossing begint dus niet met een toolselectie. Zij begint met een proces, aantoonbare bedrijfswaarde, betrouwbare data en duidelijke verantwoordelijkheden. Daar komen toegangsbeheer, gegevensclassificatie, logging, monitoring, evaluatie en incidentafhandeling vervolgens als vanzelf bij.
De grootste vooruitgang komt niet alleen van een beter model. Die komt van een betere samenwerking tussen mensen, processen, data en technologie.
[Lees meer over Loop-engineering]
AI vraagt om nieuwe businessmodellen
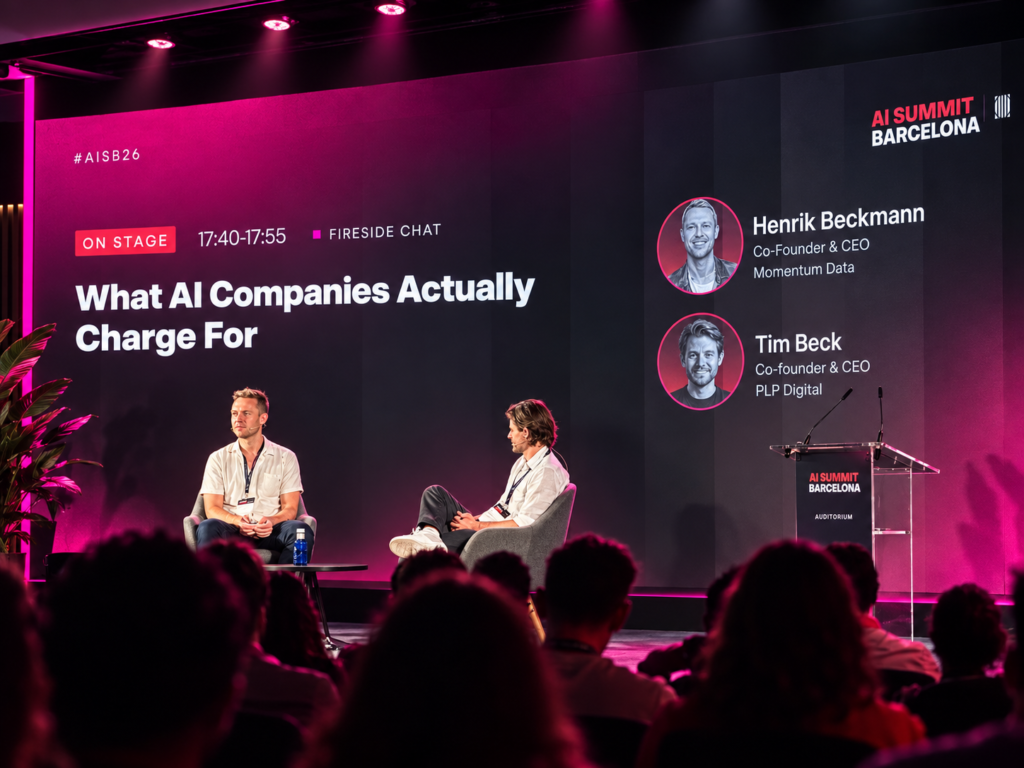
Ook de economische kant van AI kreeg aandacht. Traditionele SaaS is grotendeels gebouwd rond seats: een organisatie betaalt per gebruiker, per maand. Maar een agent past niet altijd in dat model.
Wanneer een AI-systeem duizenden taken uitvoert, variabele inferencekosten heeft en delen van menselijk werk versnelt of overneemt, verschuift pricing steeds vaker naar een combinatie van gebruik, resultaat en geleverde waarde.
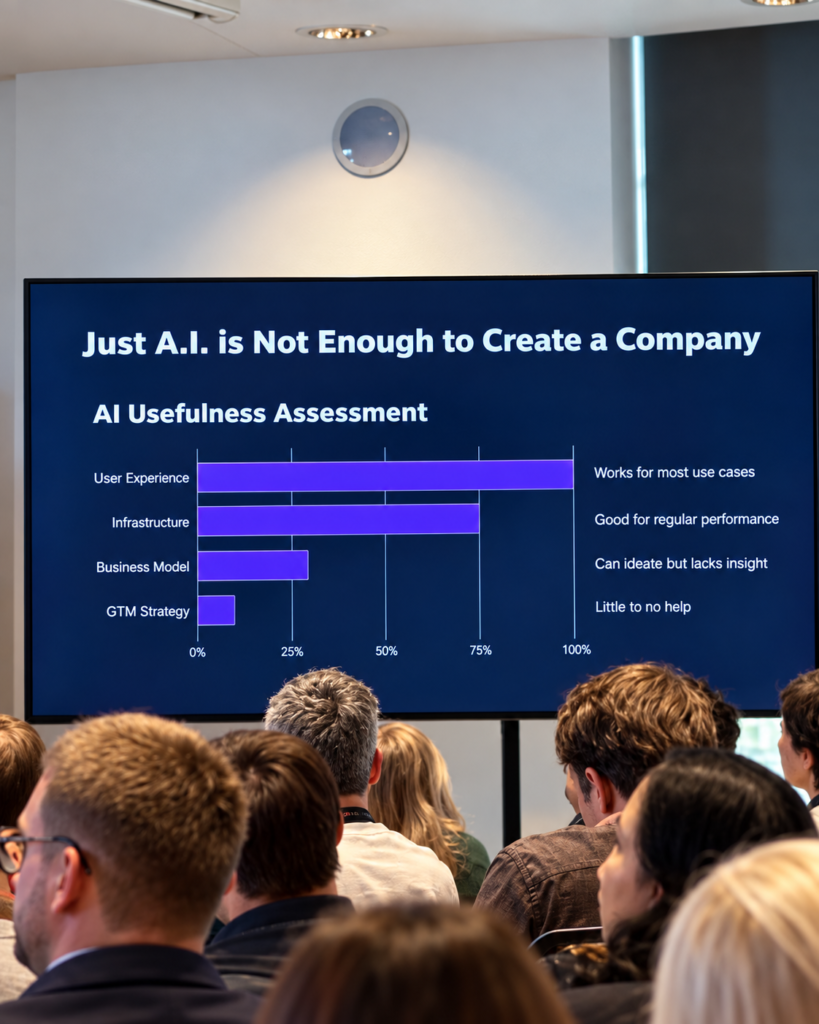
Bouwen is eenvoudiger geworden. Distributie, differentiatie en een product maken waarvoor klanten echt willen betalen, zijn dat niet.
Voor organisaties betekent dit dat een AI-businesscase verder gaat dan licentiekosten. Neem ook integratie, beheer, data governance, menselijke review, uitzonderingsafhandeling, risico’s en de kosten om een oplossing actueel en toetsbaar te houden mee. Pas dan ontstaat een eerlijk beeld van kosten, opbrengsten en schaalbaarheid.
[Lees meer over het AI model canvas, de methode van DIKW om tot een goed onderbouwde business case te komen]
Mijn belangrijkste takeaway
Mijn belangrijkste takeaway uit Barcelona is niet één specifiek model, framework of product. Het is de convergentie van disciplines.
Agentic engineering wordt steeds meer een combinatie van software engineering, data engineering, platform engineering, AI evaluation, security, governance, product design en business process design.
Het model zit midden in dat systeem, maar ís steeds minder vaak het systeem.
De organisaties die betrouwbare context, memory, tools, permissions, evaluaties en menselijke beslismomenten goed combineren, bouwen duurzamere oplossingen dan organisaties die alleen het nieuwste model achter een chatinterface zetten.
Sven Bennema | AI engineer | DIKW

From Gaudí to GPT
Barcelona vormde een passende achtergrond voor deze discussie.
From Gaudí to GPT. Van modellen naar agents. En steeds meer: van AI-demo’s naar engineered systems die daadwerkelijk werk uitvoeren.
De toekomst van enterprise AI wordt niet bepaald door wie het beste model gebruikt, maar door wie het beste systeem eromheen bouwt.